Developer StroyHouse LIST

Recent Story
RAG를 활용한 LLM 서비스 구축
STEP 32 - 셀프호스팅 LLM으로 RAG 구축하기
셀프호스팅 LLM으로 RAG 구축하기 - vLLM과 Ollama지난 글까지 운영·거버넌스 파트를 마무리했습니다. 지금까지 다룬 모든 LLM 호출은 OpenAI 같은 외부 API를 전제로 했습니다. 이번 글부터는 LLM 인프라 심화 파트로 넘어가서, 외부 API 대신 LLM을 직접 서버에 올려 운영하는 셀프호스팅 방식을 다룹니다.1. 왜 셀프호스팅을 고려하게 되는가지난 비용 모니터링 글에서 다룬 것처럼, 트래픽이 늘어날수록 외부 API 비용은 계속 누적됩니다. 또한 보안이 중요한 도메인에서는 문서와 질문이 외부 서버로 나가는 것 자체가 부담일 수 있습니다.[외부 API 방식]장점: 인프라 관리 불필요, 최신 모델 즉시 사용 가능단점: 트래픽 비례 비용, 데이터가 외부로 전송됨[셀프호스팅 방식]장점: 데이터..
RAG를 활용한 LLM 서비스 구축
STEP 31 - RAG에서 민감정보 보호하기
개인정보(PII) 마스킹 처리 - RAG에서 민감정보 보호하기지난 글에서 문서의 만료와 폐기를 관리하는 라이프사이클 정책을 다뤘습니다. 이번 글에서는 운영·거버넌스 파트의 마지막 주제로, 문서 안에 포함된 개인정보(PII)가 검색과 답변 과정에서 그대로 노출되지 않도록 마스킹하는 방법을 정리합니다.1. RAG에서 PII 노출이 왜 특히 위험한가일반 DB 조회는 필요한 컬럼만 SELECT하면 되지만, RAG는 문서 청크 전체를 통째로 LLM에 넘기고, 그 내용이 그대로 답변에 녹아들 수 있습니다.문서 원본: "김철수(주민번호 900101-1******, 010-1234-5678)님은 2024년 3월 입사하여 개발팀에 배속되었습니다."질문: "개발팀에 언제 입사한 사람 있어?"LLM 답변: ..
성능 최적화
성능 최적화 STEP 32 - CQRS 패턴으로 명령과 조회의 책임 분리
성능 최적화 32편 - CQRS 패턴으로 명령과 조회의 책임 분리하기21편에서는 읽기 전용 Replica로 조회를 분리했고, 28편에서는 검색을 위해 Elasticsearch에 별도로 데이터를 동기화했습니다. 사실 이 둘은 모두 CQRS(Command Query Responsibility Segregation)라는 더 큰 개념의 부분적인 적용이었습니다. 이번 글에서는 이 패턴을 정식으로 정리하고, 언제 어디까지 적용해야 하는지를 다룹니다.1. CQRS란CQRS는 데이터를 변경하는 작업(Command)과 조회하는 작업(Query)을, 서로 다른 모델로 완전히 분리하는 패턴입니다.[기존 방식 - 하나의 모델]Order 엔티티 하나로 저장도 하고, 조회도 하고, 목록도 뽑고, 통계도 냄[CQRS - 모델 분리..
성능 최적화
성능 최적화 STEP 31 - Caffeine + Redis로 멀티 레벨 캐싱 구성하기
성능 최적화 31편 - Caffeine + Redis로 멀티 레벨 캐싱 구성하기3편에서 Redis로 캐싱 전략을, 14편에서 캐시 스탬피드 방지를 다뤘습니다. 그런데 아무리 Redis가 빨라도, 결국 네트워크를 한 번 거쳐야 합니다. 이번 글에서는 애플리케이션 서버 안에 로컬 캐시를 두고 Redis와 함께 계층화해서, Redis 조회조차 줄이는 멀티 레벨 캐싱을 정리합니다.1. Redis만으로도 부족할 수 있는 이유Redis 캐싱을 적용하면 DB 조회는 확실히 줄어들지만, 여전히 매 요청마다 네트워크를 통해 Redis에 접근해야 합니다.[DB 직접 조회] 평균 30ms[Redis 조회] 평균 1~2ms (네트워크 왕복 포함)[로컬 메모리 조회] 평균 0.01ms 이하숫자만 보면 Redis도 이미 ..
RAG를 활용한 LLM 서비스 구축
STEP 30 - 문서 라이프사이클 관리
문서 라이프사이클 관리 - 만료와 폐기 정책지난 글에서 재해 복구 전략을 다루며 원본 문서 보관의 중요성을 강조했습니다. 그런데 문서를 안전하게 보관하는 것 못지않게 중요한 문제가 하나 더 있습니다. 시간이 지나면서 더 이상 유효하지 않은 문서가 벡터 DB에 그대로 남아, 오히려 잘못된 답변의 원인이 되는 상황입니다. 이번 글에서는 문서의 만료와 폐기를 체계적으로 관리하는 방법을 정리합니다.1. 오래된 문서가 왜 문제가 되는가RAG는 검색된 문서를 그대로 근거 삼아 답변하는 구조이기 때문에, 폐기된 정책이나 만료된 규정이 벡터 DB에 남아있으면 그 내용을 그대로 사실처럼 답변에 포함시킵니다.질문: "재택근무는 몇 회까지 가능해?"벡터 DB에 남아있는 문서들:- (2023년 작성, 폐기됨) "재택근무는 주..
RAG를 활용한 LLM 서비스 구축
STEP 29 - RAG 시스템 재해 복구(DR) 전략
RAG 시스템 재해 복구(DR) 전략지난 글에서 벡터 DB를 파티셔닝과 샤딩으로 확장하는 방법을 다뤘습니다. 규모가 커진 시스템일수록 장애가 났을 때 피해도 커지기 마련입니다. 이번 글에서는 벡터 DB나 LLM API 제공사에 장애가 발생했을 때 RAG 서비스를 어떻게 지속시킬지, 재해 복구(DR) 전략을 정리합니다.1. RAG 시스템의 장애 지점은 어디인가지금까지 다룬 RAG 파이프라인을 장애 관점에서 다시 살펴보면, 장애가 날 수 있는 지점이 생각보다 여러 곳에 흩어져 있습니다.[문서 적재 경로]원본 문서 저장소 → 벡터 DB (pgvector)[질의응답 경로]임베딩 API → 벡터 DB → Reranker API → LLM API이 중 하나라도 장애가 나면 전체 답변이 실패할 수 있습니다. 특히 임..
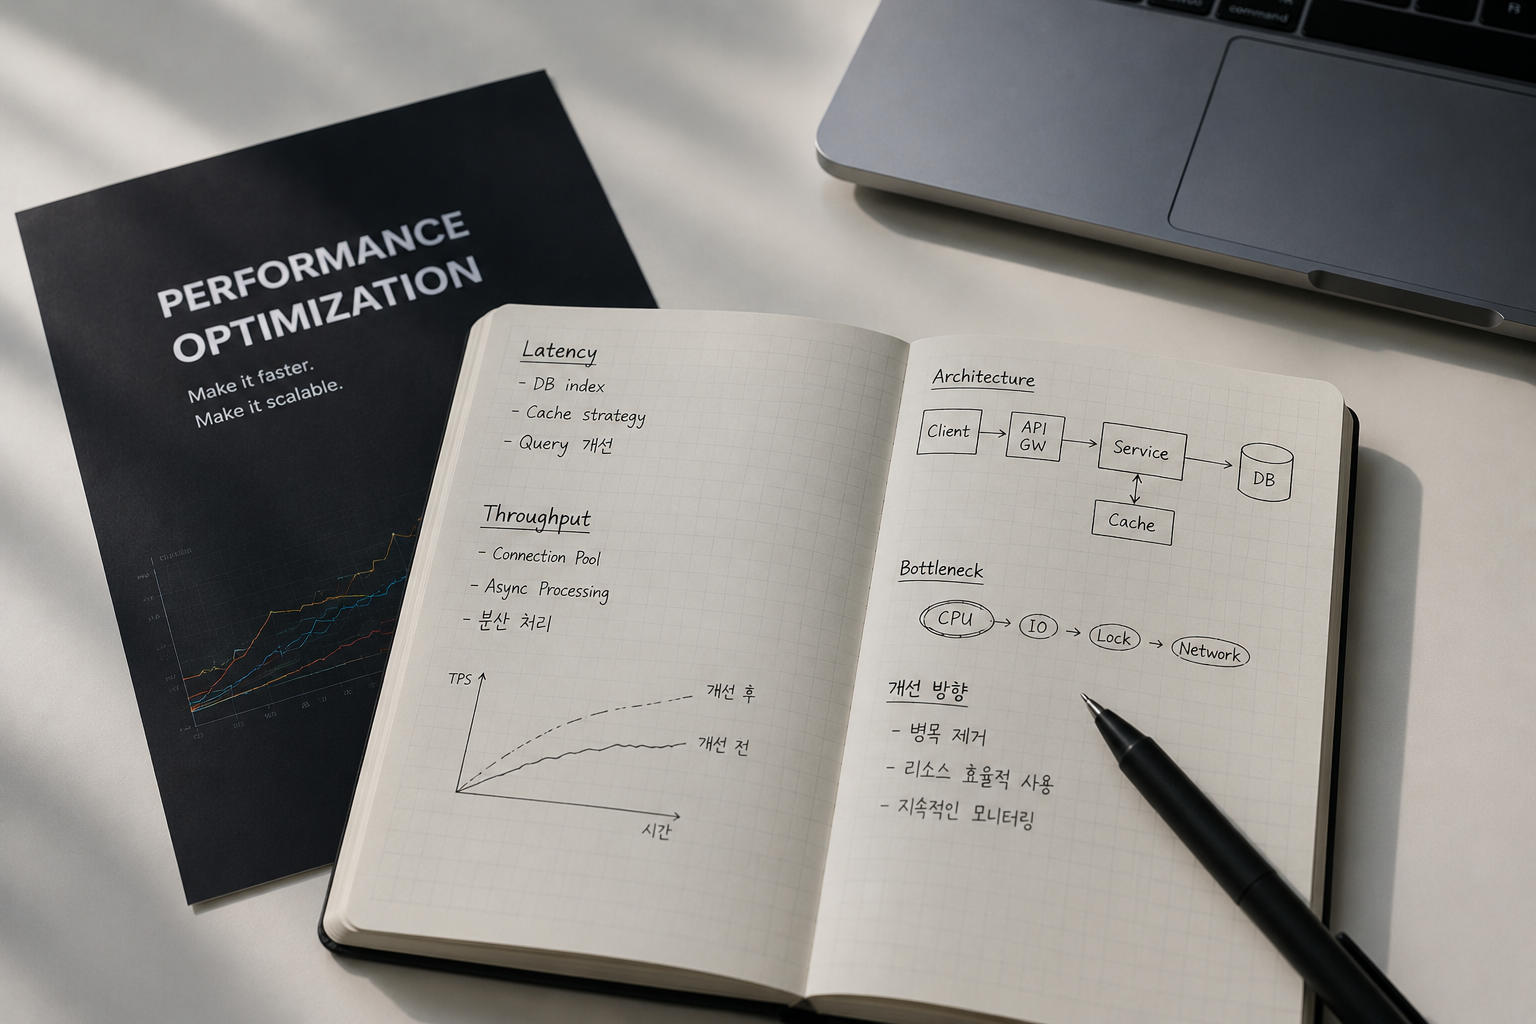
성능 최적화
성능 최적화 STEP 30 - Transactional Outbox 패턴
성능 최적화 30편 - Transactional Outbox 패턴으로 이벤트 발행 신뢰성 확보하기29편에서 Saga 패턴을 다루며, 각 서비스가 로컬 트랜잭션을 커밋한 뒤 이벤트를 발행해 다음 단계로 넘어간다고 설명했습니다. 그런데 여기엔 숨겨진 문제가 하나 있습니다. DB 커밋과 이벤트 발행이 하나의 원자적 작업이 아니라는 점입니다. 이번 글에서는 이 문제(Dual Write Problem)와, 이를 해결하는 Transactional Outbox 패턴을 정리합니다.1. Dual Write Problem - 두 시스템에 동시에 쓸 수 없다11편에서 봤던 주문 완료 로직을 다시 보겠습니다.@Transactionalpublic void completeOrder(Long orderId) { Order o..
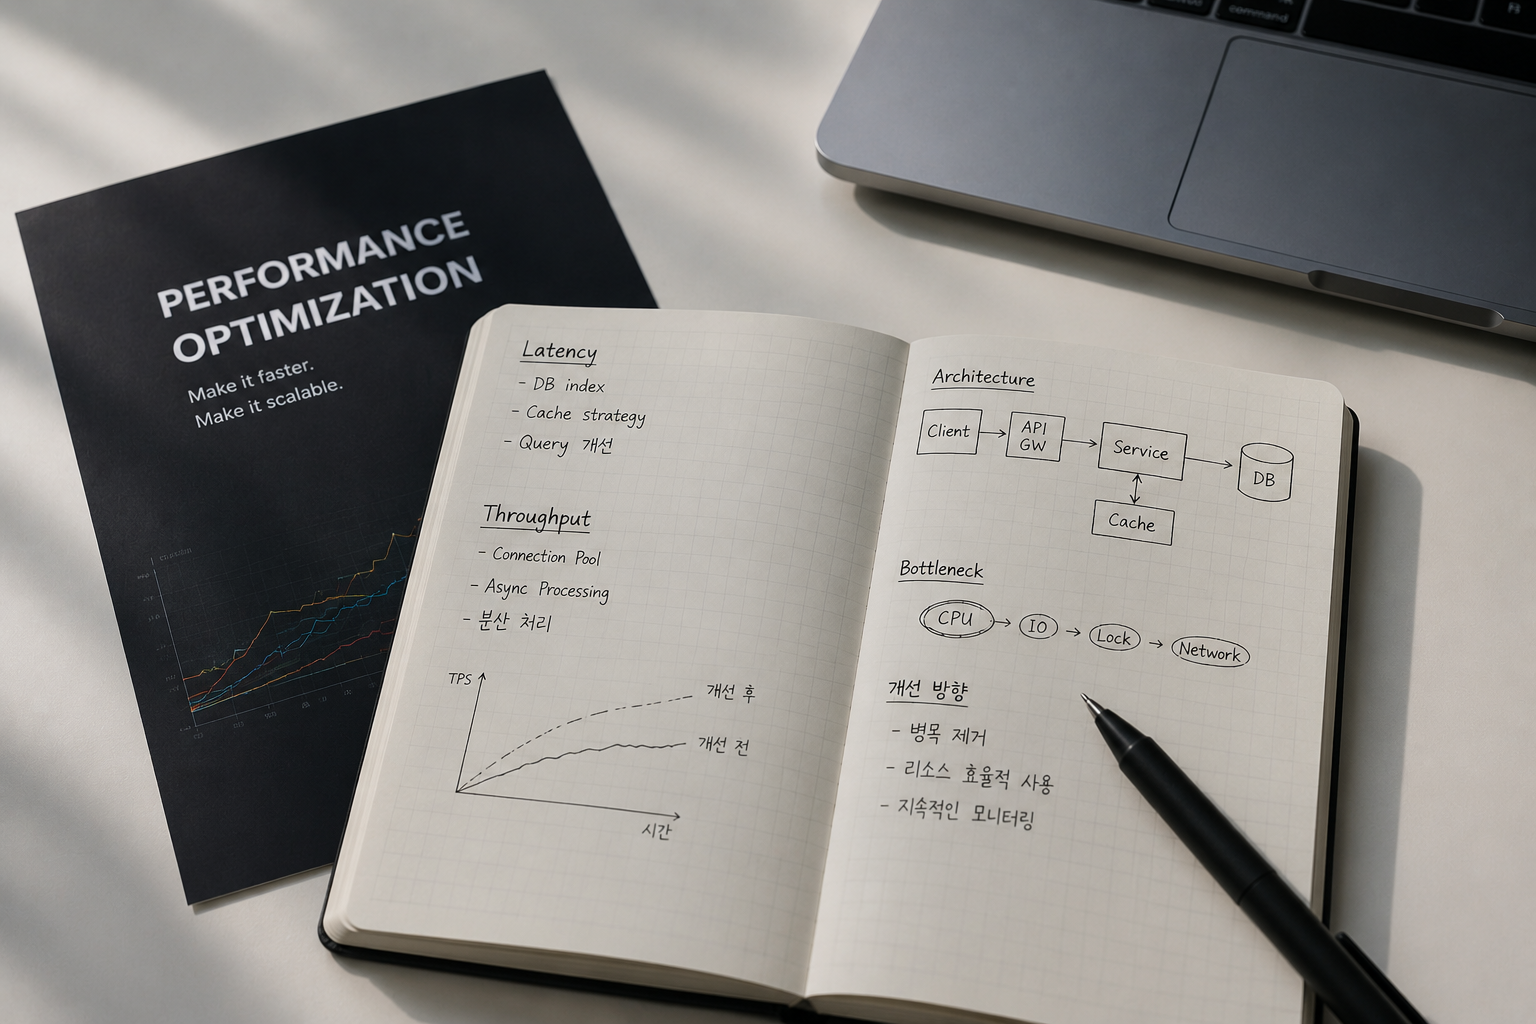
성능 최적화
성능 최적화 STEP 29 - Saga 패턴으로 트랜잭션 처리하기
성능 최적화 29편 - Saga 패턴으로 여러 서비스에 걸친 트랜잭션 처리하기11편 Kafka, 23편 서킷 브레이커, 28편 Elasticsearch 동기화까지, 시스템이 여러 서비스로 나뉜 구조를 계속 다뤄왔습니다. 그런데 정작 가장 근본적인 질문 하나를 남겨뒀습니다. 주문, 결제, 재고가 각각 다른 서비스와 다른 데이터베이스에 있다면, 하나의 트랜잭션으로 묶을 수 없는 이 작업들을 어떻게 안전하게 처리할까요? 이번 글에서는 이 문제를 푸는 Saga 패턴을 정리합니다.1. 단일 데이터베이스에서는 당연했던 것같은 데이터베이스 안에서는 @Transactional로 여러 작업을 하나로 묶고, 하나라도 실패하면 전부 롤백시킬 수 있었습니다.@Transactionalpublic void createOrder(..
Top 10 Story
데이터베이스
DATABASE SEMI PROJECT - MOVIE RANK DATA
★ MOVIE RANK DATA https://movie.naver.com/movie/sdb/rank/rmovie.naver 랭킹 : 네이버 영화 영화, 영화인, 예매, 박스오피스 랭킹 정보 제공 movie.naver.com 현재 네이버 영화에 있는 순위 목록을 크롤링 하여, 1. 개념적 모델링 2. 논리적 모델링 3. 물리적 모델링 4. DDL 생성 5. DML 생성 6. SELECT 검증 순으로 진행하였다. ■ STEP 1. 데이터 크롤링 현재 랭킹에 있는 정보와 영화 상세 정보들을 크롤링 하여 excel에 종합하였다. 컬럼은 총 21 컬럼으로, 1위 ~ 50위에 위치하는 영화들을 가져왔다. 1. 순위 2. 제목 3. 개봉년도 4. 관람객 평점 5. 평론가 평점 6. 네티즌 평점 7. 개요 8. 장르..
깃허브
깃허브 초기 셋팅하기
★ 깃(Git) 설치 먼저 설치하기 위해서 깃(Git) 홈페이지(https://git-scm.com/)에 들어가야 한다. 깃(Git) 홈페이지에 들어오시면 'Latest source Release'라는 부분에 'Download for Windows'를 클릭하셔서 설치할 수 있고, 설치 과정은 계속 다음(또는 Next)을 눌러주면 된다. 보통 윈도우 데스크탑 설치는 64-bit Git for Windows Setup을 설치하면 된다. 설치 완료 ★ 설치 완료 후 Git Bash를 클릭하여 실행한다. (!!사용자명과 이메일 주소는 깃허브의 등록사항과 같아야한다) git config -- global user.name "사용자명" git config --global user.email "아이디@이메일주소" g..
RAG를 활용한 LLM 서비스 구축
STEP 23 - 구조화된 데이터(엑셀·테이블) RAG에 통합하기
구조화된 데이터(엑셀·테이블) RAG에 통합하기지난 글에서 Query Routing을 통해 정형 데이터 질문은 Text-to-SQL로 분기하는 구조를 다뤘습니다. 그런데 실무에서 다루는 정형 데이터가 항상 정돈된 DB 테이블 형태인 것은 아닙니다. 엑셀 파일, CSV로 흩어진 사내 데이터가 훨씬 많습니다. 이번 글에서는 이런 구조화된 데이터를 RAG 파이프라인에 통합하는 방법을 다룹니다.1. 엑셀 데이터를 텍스트처럼 임베딩하면 안 되는 이유지금까지 다룬 청킹 방식을 엑셀에 그대로 적용하면 문제가 생깁니다.[엑셀 원본]| 부서 | 담당자 | 예산(만원) ||------|--------|-----------|| 개발팀 | 김철수 | 5000 || 영업팀 | 이영희 | 3200 || 인사팀 | 박민수 | 18..
성능 최적화
성능 최적화 STEP 31 - Caffeine + Redis로 멀티 레벨 캐싱 구성하기
성능 최적화 31편 - Caffeine + Redis로 멀티 레벨 캐싱 구성하기3편에서 Redis로 캐싱 전략을, 14편에서 캐시 스탬피드 방지를 다뤘습니다. 그런데 아무리 Redis가 빨라도, 결국 네트워크를 한 번 거쳐야 합니다. 이번 글에서는 애플리케이션 서버 안에 로컬 캐시를 두고 Redis와 함께 계층화해서, Redis 조회조차 줄이는 멀티 레벨 캐싱을 정리합니다.1. Redis만으로도 부족할 수 있는 이유Redis 캐싱을 적용하면 DB 조회는 확실히 줄어들지만, 여전히 매 요청마다 네트워크를 통해 Redis에 접근해야 합니다.[DB 직접 조회] 평균 30ms[Redis 조회] 평균 1~2ms (네트워크 왕복 포함)[로컬 메모리 조회] 평균 0.01ms 이하숫자만 보면 Redis도 이미 ..
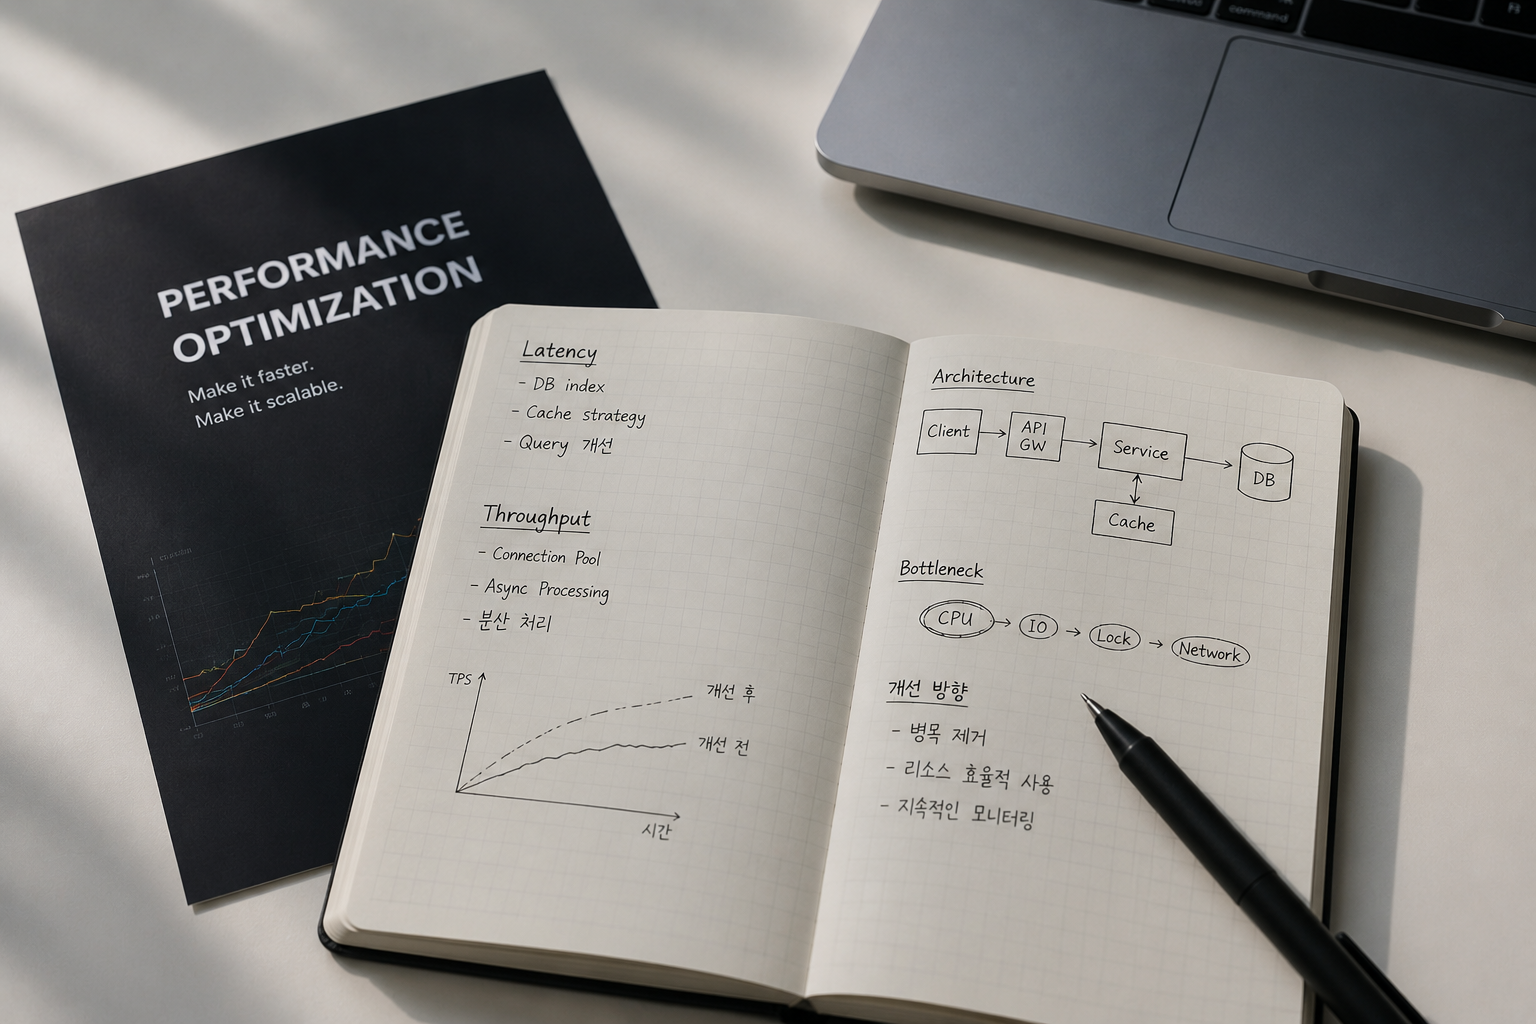
성능 최적화
성능 최적화 STEP 28 - Elasticsearch로 검색 성능 개선하기
성능 최적화 28편 - Elasticsearch로 검색 성능 개선하기5편에서 인덱스를 다루며 LIKE '%검색어%'처럼 앞쪽에 와일드카드가 붙는 검색은 일반 B-Tree 인덱스로는 처리할 수 없고, 검색 전용 엔진 도입을 고려해야 한다고 짚었습니다. 이번 글에서는 그 대안인 Elasticsearch를 도입해 검색 성능을 개선하는 방법을 정리합니다.1. RDB의 LIKE 검색이 느린 이유를 다시 보기select * from products where name like '%무선 이어폰%';%검색어% 형태는 인덱스를 활용하지 못해 테이블 전체를 훑는 풀 스캔이 발생합니다. 상품이 수백만 건이라면, 검색할 때마다 전체 테이블을 스캔해야 해서 응답 시간이 데이터량에 비례해 계속 느려집니다. 게다가 "무선이어폰"(..
RAG를 활용한 LLM 서비스 구축
STEP 20 - GraphRAG
GraphRAG - 지식 그래프 기반 RAG지난 글까지 벡터 검색과 Hybrid Search로 관련 문서를 찾는 방법을 다뤄왔습니다. 그런데 벡터 검색은 문서 하나하나를 독립적으로 비교하는 방식이라, 문서 여러 개에 걸쳐 흩어진 관계 정보를 종합해야 답할 수 있는 질문에는 약합니다. 이번 글에서는 이 빈틈을 메우는 GraphRAG의 개념과 구조를 정리합니다.1. 벡터 검색이 답하기 어려운 질문 유형지금까지 다뤄온 벡터 검색은 "질문과 의미가 비슷한 청크를 찾는" 방식입니다. 그런데 다음과 같은 질문은 어느 한 청크만 봐서는 답이 나오지 않습니다.질문: "김철수 팀장이 승인권을 가진 정책들을 전부 알려줘"문서 A: "재택근무는 김철수 팀장 승인 하에 가능합니다"문서 B: "출장비 정산은 김철수 팀장 결재가..
RAG를 활용한 LLM 서비스 구축
STEP 4 - 임베딩이란
임베딩(Embedding)이란 - 텍스트를 벡터로 바꾸는 원리지난 글에서 RAG의 전체 구조를 살펴보면서 "텍스트를 벡터로 변환해서 저장한다"는 과정이 나왔습니다. 이번 글에서는 RAG의 첫 단추가 되는 임베딩(Embedding)이 정확히 무엇이고, 왜 텍스트를 굳이 숫자로 바꿔야 하는지 정리합니다.1. 임베딩이란 무엇인가임베딩은 텍스트(단어, 문장, 문단)를 컴퓨터가 의미 단위로 비교할 수 있는 숫자 배열(벡터)로 변환하는 작업입니다."오늘 날씨가 좋다" → [0.021, -0.184, 0.093, ..., 0.077] (예: 1536차원)"today's weather is nice" → [0.019, -0.176, 0.088, ..., 0.081]여기서 중요한 건 단순히 숫자로 바꾸는 게 목적이 아니..
웹페이지
VSCode로 HTML 환경구축
★ Visual Studio Code 다운 https://code.visualstudio.com/Download Download Visual Studio Code - Mac, Linux, Windows Visual Studio Code is free and available on your favorite platform - Linux, macOS, and Windows. Download Visual Studio Code to experience a redefined code editor, optimized for building and debugging modern web and cloud applications. code.visualstudio.com download - system - window 6..

웹페이지
HTML STEP 3 - HR
★ Horizontal Rule, 수평바, 구분자 문단과 문단을 구분하는 역할 단독 태그 ★ 속성 1. size : 선의 두께 2. width : 선의 너비(픽셀:절대크기, %:상대크기) 3. align : 수평 정렬 4. color : 선의 색상 5. noshade : 그림자 유무 6. title : 풍선 도움말(tooltip, hover text) ★ HTML 속성 유형 1. 숫자(단위 없음) 픽셀(px) > 화소 > 화상(이미지)를 구성하는 최소 단위> 단일 색상을 가지는 점 1개 글자수 2. 숫자(단위 %) 100%의 기준이 누구인지 부모 태그 영역을 100으로 하는 상대 단위 3. 열거형 정해져있는 속성값 중 하나를 선택해서 사용 4. 색상 색상명, RGB 5. 플래그형(boolean) 속성명 ..
RAG를 활용한 LLM 서비스 구축
STEP 9 - LangChain으로 RAG 파이프라인 처음부터 구축하기
LangChain으로 RAG 파이프라인 처음부터 구축하기지금까지 임베딩, 벡터 유사도 검색, 벡터 DB, pgvector 실습, 청킹 전략까지 RAG를 이루는 조각들을 하나씩 살펴봤습니다. 이번 글에서는 이 조각들을 LangChain으로 엮어서, 문서 업로드부터 질의응답까지 전체 RAG 파이프라인을 하나의 흐름으로 구축해보겠습니다.1. LangChain이 하는 역할지금까지 직접 짰던 코드(청킹 → 임베딩 → DB 저장 → 검색 → 프롬프트 조합)를 하나하나 연결하는 게 번거로웠다면, LangChain은 이 단계들을 표준화된 컴포넌트로 제공해서 파이프라인을 훨씬 짧은 코드로 구성할 수 있게 해줍니다.[직접 구현]청킹 함수 작성 → 임베딩 API 호출 → DB insert 쿼리 작성→ 검색 쿼리 작성 → 프..